均值估计:从 non-incremental 到 incremental

在强化学习和机器学习中,incremental(增量式)指的是一类逐步更新的方法:每获得一条新数据(或一个完整片段),就立即用它来修正当前估计,而不是等到收集全部数据后再一次性计算。

考虑一个随机变量 XX,取值集合为 X\mathcal{X}。若要估计 E[X]\mathbb{E}\left[X\right],在 model-free 的情况下,可以采样一系列 i.i.d. 的样本 {xi}i=1n\{x_i\}_{i=1}^n,则 E[X]\mathbb{E}\left[X\right] 可以被这些样本的均值估计

E[X]≈xˉ=1n∑i=1nxi\mathbb{E}\left[X\right]\approx\bar{x}=\frac{1}{n}\sum_{i=1}^n x_i

这实际上就是蒙特卡洛法。根据大数定律可知当 n→∞n\to\infty 时 xˉ→E[X]\bar{x}\to\mathbb{E}\left[X\right]。

在计算 xˉ\bar{x} 的过程中,有两种方法,分别是 non-incremental 和 incremental。前者是在收集好所有样本 {xi}i=1n\{x_i\}_{i=1}^n 后一次计算均值得到 xˉ\bar{x},其弊端是如果样本数量非常大或者采样过程很慢,那么需要等很长时间才能得到 xˉ\bar{x}。后者则采取增量的方式即时获取新值。

具体而言,设

wk+1≐1k∑i=1kxi,k=1,2,…w _ {k+1} \doteq \frac {1}{k} \sum_ {i = 1} ^ {k} x _ {i}, \quad k = 1, 2, \dots

即前 ii 个样本的均值。

为了后续公式形式上的简结,这里用 wk+1w_{k+1} 而非 wkw_k 来表示前 kk 个样本的均值。

则有

wk=1k−1∑i=1k−1xi,k=2,3,…w _ {k} = \frac {1}{k-1} \sum_ {i = 1} ^ {k-1} x _ {i}, \quad k = 2,3, \dots

而 wk+1w_{k+1} 可以用 wkw_{k} 表示:

wk+1=1k∑i=1kxi=1k(∑i=1k−1xi+xk)=1k((k−1)wk+xk)=wk−1k(wk−xk).w _ {k + 1} = \frac {1}{k} \sum_ {i = 1} ^ {k} x _ {i} = \frac {1}{k} \left(\sum_ {i = 1} ^ {k - 1} x _ {i} + x _ {k}\right) = \frac {1}{k} \left((k - 1) w _ {k} + x _ {k}\right) = w _ {k} - \frac {1}{k} \left(w _ {k} - x _ {k}\right).

即

wk+1=wk−1k(wk−xk)w_{k+1}=w_{k}-\frac{1}{k}(w_{k}-x_k)

上述公式可以被用于增量式的计算样本均值 xˉ\bar{x}。就像下面这样:

w1=x1,w2=w1−11(w1−x1)=x1,w3=w2−12(w2−x2)=x1−12(x1−x2)=12(x1+x2),w4=w3−13(w3−x3)=13(x1+x2+x3),⋮wk+1=1k∑i=1kxi.\begin{aligned} w _ {1} &= x _ {1}, \\ w _ {2} &= w _ {1} - \frac {1}{1} \left(w _ {1} - x _ {1}\right) = x _ {1}, \\ w _ {3} &= w _ {2} - \frac {1}{2} \left(w _ {2} - x _ {2}\right) = x _ {1} - \frac {1}{2} \left(x _ {1} - x _ {2}\right) = \frac {1}{2} \left(x _ {1} + x _ {2}\right), \\ w _ {4} &= w _ {3} - \frac {1}{3} \left(w _ {3} - x _ {3}\right) = \frac {1}{3} \left(x _ {1} + x _ {2} + x _ {3}\right), \\ \vdots \\ \\ w _ {k + 1} &= \frac {1}{k} \sum_ {i = 1} ^ {k} x _ {i}. \end{aligned}

这种 incremental 计算方法的好处就是每收集到一个新样本就可以立即更新均值,也就是 E[X]\mathbb{E}\left[X\right] 的估计结果。尽管前期估计的 E[X]\mathbb{E}\left[X\right] 可能很不精确,但总比 non-incremental 在收集完样本前什么也没有要好很多,而且当采集的样本越来越多,估计的值也会越来越精确。

进一步地,可以将更新公式推广为

wk+1=wk−αk(wk−xk)w_{k+1}=w_{k}-\alpha_k(w_{k}-x_k)

其中 αk>0\alpha_k>0。在上面的例子中 αk=1k\alpha_k=\frac{1}{k},也因此 wkw_k 可以被显式地写为样本的均值,且当 k→∞k\to\infty 时收敛到 E[X]\mathbb{E}\left[X\right]。事实上,后面的 Robbins-Monro 算法证明,只要系数 αk\alpha_k 的序列 {αk}\{\alpha_k\} 满足一定的条件,wkw_k 就始终能够在 k→∞k\to\infty 时收敛到 E[X]\mathbb{E}\left[X\right]。

Robbins-Monro 算法

stochastic approximation(随机近似)是指一类用于解决求根问题或优化问题的随机迭代算法。相比于许多其它的算法,例如基于梯度的算法(如牛顿迭代法等),stochastic approximation 非常的强大因为它不需要目标函数的表达式或者导数。**Robbins-Monro(RM)**算法是 stochastic approximation 的一个开创性的工作,著名的 **stochastic gradient descent(SGD,随机梯度下降)**就是它的一个特殊形式。

找零点问题

考虑求下述方程的根

g(w)=0g(w)=0

其中 w∈Rw\in\mathbb{R} 是要求解的未知变量,g:R→Rg:\mathbb{R}\to\mathbb{R} 是一个函数。

许多问题都可以转化为上述的找零点问题。例如对目标函数 J(w)J(w) 进行优化,可以转化为求解 g(w)=∇wJ(w)=0g(w)=\nabla_w J(w)=0;或者要求方程 g(w)=cg(w)=c 的根,可以转化为找 g(w)−cg(w)-c 这个新函数的零点。

如果 gg 的表达式或者导数已知,则有很多数值方法(例如牛顿迭代法)可以使用。但如果 gg 未知(这实际上也是强化学习 model-free 的情况),那么只能获得 g(w)g(w) 带噪声的观察值 g~(w,η)\tilde{g}(w,\eta):

g~(w,η)=g(w)+η\tilde{g}(w,\eta)=g(w)+\eta

其中 η∈R\eta\in\mathbb{R} 是观察中产生的误差,也就是噪声。

g~(w,η)=g(w)+η\tilde{g}(w,\eta)=g(w)+\eta 可以理解为对于输入 ww,经过函数 gg,我们想得到(看到)的真实值是 g(w)g(w),但实际上由于不可控因素或外界影响,我们的观察会带有噪声 η\eta,因此我们只能看到带有噪声的值 g(w)+ηg(w)+\eta,也就是 g~(w,η)\tilde{g}(w,\eta)。

所以,当 gg 未知时,我们面对的是一个黑箱系统,只有输入 ww 和带噪声的输出 g~(w,η)\tilde{g}(w,\eta) 是已知的(如下图),因此我们的目的就是利用 ww 和 g~\tilde{g} 来寻找 g(w)=0g(w)=0 的根。

image-20260426213835544

Robbins-Monro

Robbins-Monro(RM)算法通过利用每次采样 wkw_k 得到的观测值 g~(wk,ηk)\tilde{g}(w_k,\eta_k) 来更新根的估计值,迭代公式为

wk+1=wk−akg~(wk,ηk),k=1,2,3,…w_{k+1}=w_{k}-a_{k}\tilde{g}(w_{k},\eta_{k}),\quad k=1,2,3,\dots

其中 wkw_k 是第 kk 次根的估计,g~(wk,ηk)\tilde{g}(w_k,\eta_k) 是第 kk 次带噪声的观测值,而 αk>0\alpha_k>0 是第 kk 个正系数。同时,如果满足以下三个条件,则 wkw_k 几乎必然收敛到 g(w)=0g(w)=0 的根 w∗w^*:

  • 对于任意 ww,都有 0<c1≤∇wg(w)≤c20<c_1\le\nabla_w g(w)\le c_2;
  • ∑k=1∞ak=∞\sum_{k=1}^\infty a_k=\infty 且 ∑k=1∞ak2<∞\sum_{k=1}^{\infty}a_k^2<\infty;
  • E[ηk∣Hk]=0\mathbb{E}\left[\eta_k\mid\mathcal{H}_k\right]=0 且 E[ηk2∣Hk]<∞\mathbb{E}\left[\eta_k^2\mid\mathcal{H}_k\right]<\infty,其中 Hk={wk,wk−1,… }\mathcal{H}_k=\{w_k,w_{k-1},\dots\}。

上述的内容也被称为 Robbins-Monoro(RM)定理。

对于随机变量序列 {wk}\{w_k\} 和随机变量 w∗w^*,如果

P(lim⁡k→∞wk=w∗)=1P\left(\lim_{k\to\infty}w_k=w^*\right)=1

则称 wkw_k 几乎必然收敛到 w∗w^*。“几乎必然”也称作“以概率 1”或“几乎处处”。

也就是说,除去一个概率为零(不可能发生)的样本路径(即“坏”的结果),所有其他样本路径都使得 wkw_k 趋近于 w∗w^*。虽然不能保证每条随机路径都收敛,但那些不收敛的路径合起来发生的概率是 0。在实际应用中,几乎肯定能观察到收敛。

例子

先通过两个例子来更直观地理解 RM 算法。两个例子都是在 gg 未知的情况下,求解 g(w)=0g(w)=0。

第一个例子,假设 g(w)=w3−5g(w)=w^3-5 而我们未知,方程 g(w)=0g(w)=0 真实的根为 w∗=51/3≈1.71w^*=5^{1/3}\approx 1.71。假设我们只能观测到输入 ww 以及带有噪声的输出 g~(w,η)=g(w)+η\tilde{g}(w,\eta)=g(w)+\eta,其中 η\eta 是模拟的噪声,遵循 i.i.d. 且服从标准正态分布。利用 RM 算法,初始值 w1=0w_1=0,系数 ak=1ka_k=\frac{1}{k},由此得到的迭代收敛过程如下图。这个例子体现了即使观测的值 g~\tilde{g} 相比真实值 gg 存在误差,但是估计值 wkw_k 依然可以收敛到真实的根。

image-20260426231027172

其实上述例子中的 g(w)g(w) 并不完全符合 RM 定理的第一个条件,因此初始值 w1w_1 的选取不是任意的。

第二个例子从直觉上展示 RM 算法收敛的原因,假设 g(w)=tanh⁡(w−1)g(w)=\tanh(w-1),方程 g(w)=0g(w)=0 真实的根为 w∗=1w^*=1。为了方便展示,假设每次观测的噪声 ηk≡0\eta_k\equiv0,因此观测值就是真实值,即 g~(wk,nk)=g(wk)\tilde{g}(w_k,n_k)=g(w_k)。利用 RM 算法,其迭代公式为 wk+1=wk−akg(wk)w_{k+1}=w_k-a_kg(w_k),得到收敛过程如下图,可以发现 wkw_k 最后收敛到真实的根 11。

在这个例子中,从直觉上来说:

  • 当 wk>w∗w_k>w^* 时,有 g(wk)>0g(w_k)>0,因此 wk+1=wk−akg(wk)<wkw_{k+1}=w_k-a_kg(w_k)<w_k。如果 akg(wk)a_kg(w_k) 足够小,那么就有 w∗<wk+1<wkw^*<w_{k+1}<w_k,因此 wk+1w_{k+1} 相比 wkw_k 会更靠近 w∗w^*。
  • 当 wk<w∗w_k<w^* 时,有 g(wk)<0g(w_k)<0,因此 wk+1=wk−akg(wk)>wkw_{k+1}=w_k-a_kg(w_k)>w_k。如果 ∣akg(wk)∣\left|a_kg(w_k)\right| 足够小,那么就有 wk<wk+1<w∗w_k<w_{k+1}<w^*,因此 wk+1w_{k+1} 相比 wkw_k 会更靠近 w∗w^*。

因此从直觉上可以发现,每次迭代 wkw_k 都会里离根 w∗w^* 越来越近,wkw_{k} 会最终收敛到 w∗w^*。

image-20260426232138376

定理说明

下面依次对 Robbins-Monro 定理的每一个条件做详细说明:

  • 对于所有的 ww,都有 0<c1≤∇wg(w)≤c20<c_1\le\nabla_w g(w)\le c_2:

    0<c1≤∇wg(w)0<c_1\le\nabla_w g(w) 表明 g(w)g(w) 要求单调递增;如果 g(w)g(w) 是单调递减的,可以通过构造新函数 −g(w)-g(w) 来实现单调增。

    当 RM 算法应用于优化问题,也就是优化目标函数 J(w)J(w) 时,问题变为求解 g(w)=∇wJ(w)=0g(w)=\nabla_{w}J(w)=0,这种情况下 g(w)g(w) 单调增的性质实际上是要求 J(w)J(w) 是凸函数,而这在优化问题中其实是一个很常见且合理的假设,因为:

    • 任何局部最优解都是全局最优解:对于凸函数,只要找到一个梯度为零的点(即 g(w)=0g(w)=0 的解),这个点就一定是全局最小值点。这极大地降低了优化难度。
    • 许多实际问题可以建模为凸问题:线性回归、逻辑回归(正则化后)、支持向量机、岭回归、Lasso 等经典机器学习模型,其损失函数加上凸正则项后整体为凸函数。

    ∇wg(w)≤c2\nabla_w g(w)\le c_2 表明 g(w)g(w) 的梯度要求有上界。这也是上面第二个例子 g(w)=w3−5g(w)=w^3-5 不能随便取初始值去迭代的原因。

  • ∑k=1∞ak=∞\sum_{k=1}^\infty a_k=\infty 且 ∑k=1∞ak2<∞\sum_{k=1}^{\infty}a_k^2<\infty:

    后者要求当 k→∞k\to\infty 时 aka_k 收敛到 00,而前者要求 aka_k 收敛到 00 的速度不能太快。

    假设观测值 g~(wk,ηk)\tilde{g}(w_k,\eta_k) 有界:

    • 由于 RM 算法迭代公式

      wk+1−wk=−akg~(wk,ηk)w_{k+1}-w_k=-a_k\tilde{g}(w_k,\eta_k)

      如果 ak→0a_k\to 0,那么 akg~(wk,ηk)→0a_k\tilde{g}(w_k,\eta_k)\to0,因此 wk+1w_{k+1} 和 wkw_k 当 k→∞k\to\infty 时会非常接近,这保证了 wkw_k 的收敛性,否则 aka_k 不收敛到 00 的话,wkw_k 在 k→∞k\to\infty 时也会发生震荡。

    • 另一方面,根据迭代公式有 w2−w1=−a1g~(w1,η1),w3−w2=−a2g~(w2,η2),w4−w3=−a3g~(w3,η3),…w_2-w_1=-a_1\tilde{g}(w_1,\eta_1),w_3-w_2=-a_2\tilde{g}(w_2,\eta_2),w_4-w_3=-a_3\tilde{g}(w_3,\eta_3),\dots,逐项累加得到

      w1−w∞=∑k=1∞akg~(wk,ηk)w_1-w_{\infty}=\sum_{k=1}^{\infty}a_k\tilde{g}(w_k,\eta_k)

      如果 ∑k=1∞ak<∞\sum_{k=1}^{\infty}a_k<\infty(有界),同时又由于 g~(wk,ηk)\tilde{g}(w_k,\eta_k) 有界,因此 ∣∑k=1∞akg~(wk,ηk)∣\left|\sum_{k=1}^{\infty}a_k\tilde{g}(w_k,\eta_k)\right| 有界。设常数 bb 是它的一个上界,则有

      ∣w1−w∞∣=∣∑k=1∞akg~(wk,ηk)∣≤b\left|w_1-w_{\infty}\right|=\left|\sum_{k=1}^{\infty}a_k\tilde{g}(w_k,\eta_k)\right|\le b

      如果初始值 w1w_1 的选取与真实根 w∗w^* 的距离超过 bb,那么这会导致 wkw_k 永远无法收敛到 w∗w^*。因此 ∑k=1∞ak=∞\sum_{k=1}^\infty a_k=\infty 保证了任意的初始值都能使迭代能够收敛到真实根 w∗w^*。

    一个可行的 {ak}\{a_k\} 的选取是

    ak=1ka_k=\frac{1}{k}

    因为有

    lim⁡n→∞(∑k=1n1k−ln⁡n)=γ\lim_{n\to\infty}\left(\sum_{k=1}^n\frac{1}{k}-\ln n\right)=\gamma

    其中 γ≈0.577\gamma\approx0.577 是欧拉常数,因此 ∑k=1∞ak=∞\sum_{k=1}^\infty a_k=\infty。

    另外 Basel 问题得到

    ∑k=1∞1k2=π26\sum_{k=1}^{\infty}\frac{1}{k^2}=\frac{\pi^2}{6}

    因此 ∑k=1∞ak2<∞\sum_{k=1}^\infty a_k^2<\infty。

    但在实际应用中,aka_k 经常被选取为非常小的常数,尽管不满足 RM 的收敛条件,但也能收敛。

  • E[ηk∣Hk]=0\mathbb{E}\left[\eta_k\mid\mathcal{H}_k\right]=0 且 E[ηk2∣Hk]<∞\mathbb{E}\left[\eta_k^2\mid\mathcal{H}_k\right]<\infty,其中 Hk={wk,wk−1,… }\mathcal{H}_k=\{w_k,w_{k-1},\dots\}:

    {ηk}\{\eta_k\} 是 i.i.d. 的,与 Hk\mathcal{H}_k 无关。且这个条件说明了 ηk\eta_k 并不要求是正态分布的。

定理证明

Dvoretzky’s convergence theorem(待补充)

应用:均值估计

定义函数 g(w)g(w):

g(w)=w−E[X]g(w)=w-\mathbb{E}\left[X\right]

显然,g(w)=0g(w)=0 的根就是随机变量 XX 的期望 E[X]\mathbb{E}\left[X\right]。对于每一次输入 ww,我们只能观测到 g(w)g(w) 带噪声的观测值 g~=w−x\tilde{g}=w-x,其中 xx 是 XX 的一个采样。因此考虑使用 RM 算法去寻找 g(w)g(w) 的零点,也即 XX 的期望:选择合适的正系数 aka_k 满足 ∑k=1∞ak=∞\sum_{k=1}^{\infty}a_k=\infty 且 ∑k=1∞ak2<∞\sum_{k=1}^{\infty}a_k^2<\infty,且采集的样本 {xk}\{x_k\} 是 i.i.d.,利用迭代式

wk+1=wk−αkg~(wk,ηk)=wk−αk(wk−xk)w_{k+1}=w_k-\alpha_k\tilde{g}(w_k,\eta_k)=w_k-\alpha_k(w_k-x_k)

根据 RM 定理,当 k→∞k\to\infty 时 wkw_k 收敛到 E[X]\mathbb{E}\left[X\right]。

g~\tilde{g} 也可以被写为关于噪声 η\eta 的形式:

g~(w,η)=w−x=(w−E[X])+(E[X]−x)=g(w)+η\begin{align} \tilde{g}(w,\eta)&=w-x\\ &=(w-\mathbb{E}\left[X\right])+(\mathbb{E}\left[X\right]-x)\\ &=g(w)+\eta \end{align}

其中 η=E[X]−x\eta=\mathbb{E}\left[X\right]-x 就是观测产生的噪声,也就是误差。

根据 RM 算法在随机变量 XX 均值估计上的利用,可以发现算法的收敛性与随机变量 XX 的分布无关。

随机梯度下降(SGD)

**stochastic gradient descent(SGD,随机梯度下降)**是 gradient descent(GD,梯度下降)算法的一种,广泛应用于机器学习中的优化问题。SGD 实际上是 RM 算法的一种特殊形式。

GD

考虑下面的优化问题

min⁡wJ(w)=E[f(w,X)]\min_w J(w)=\mathbb{E}\left[f(w,X)\right]

其中 ww 是待优化的参数,而 XX 是随机变量,ww 和 XX 可以是向量或标量;而函数 f(⋅)f(\cdot) 是一个标量。

上述优化问题的直接解决方法是使用 GD。注意到 E[f(w,X)]\mathbb{E}\left[f(w,X)\right] 的梯度为 ∇wE[f(w,X)]=E[∇wf(w,X)]\nabla_w\mathbb{E}\left[f(w,X)\right]=\mathbb{E}\left[\nabla_w f(w,X)\right],因此梯度的更新公式为

wk+1=wk−αk∇wJ(wk)=wk−αkE[∇wf(wk,X)]w_{k+1}=w_{k}-\alpha_{k}\nabla_{w} J(w_{k})=w_{k}-\alpha_{k}\mathbb{E}[\nabla_{w} f(w_{k}, X)]

SGD

GD 的公式中需要计算 E[∇wf(wk,X)]\mathbb{E}\left[\nabla_wf(w_k,X)\right] 的值。如果随机变量 XX 分布已知(model-based),则可以直接公式化计算该期望值;否则(model-free,这是更常见的情况),需要采集大量 i.i.d. 的随机变量 XX 的样本 {xi}i=1n\{x_i\}_{i=1}^n 来估计该期望值(也就是蒙特卡洛法):

E[∇wf(wk,X)]≈1n∑i=1n∇wf(wk,xi)\mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right] \approx \frac {1}{n} \sum_ {i = 1} ^ {n} \nabla_ {w} f \left(w _ {k}, x _ {i}\right)

因此梯度的更新公式就变为了

wk+1=wk−αkn∑i=1n∇wf(wk,xi)w _ {k + 1} = w _ {k} - \frac {\alpha_ {k}}{n} \sum_ {i = 1} ^ {n} \nabla_ {w} f \left(w _ {k}, x _ {i}\right)

当 {xi}i=1n\{x_i\}_{i=1}^n 是全部样本时,上述公式实际上是 batch stochastoc gradient(BGD,批量梯度下降)。

当使用上面的公式更新时仍然存在问题:每次迭代更新需要等一批样本的观测值全部收集完毕才能进行。因此,如果样本是 one by one 的采集,可以每采集到一个样本就更新一次梯度:

wk+1=wk−αk∇wf(wk,xk)w _ {k + 1} = w _ {k} - \alpha_ {k}\nabla_ {w} f \left(w _ {k}, x _ {k}\right)

其中 xkx_k 是第 kk 个时间步采集的样本。上述公式就是著名的 SGD 算法,被称作 stochastic 正是因为它依靠随机的样本 {xk}\{x_k\}。

观察 SGD 的梯度更新公式,可以发现 SGD 算法实际上可以看作 RM 算法的一个应用,其收敛性可以由 RM 定理证明。记 g(w)=E[∇wf(w,X)]g(w)=\mathbb{E}\left[\nabla_wf(w,X)\right],SGD 迭代公式中的 ∇wf(wk,xk)\nabla_ {w} f \left(w _ {k}, x _ {k}\right) 就是对 XX 采样 xkx_k 得到的 g(wk)g(w_k) 观测值 g~\tilde{g},可以写为

∇wf(wk,xk)=E[∇wf(wk,X)]+(∇wf(wk,xk)−E[∇wf(wk,X)])≐E[∇wf(wk,X)]+ηk=g(wk)+ηk≐g~(wk,ηk)\begin{align} \nabla_ {w} f \left(w _ {k}, x _ {k}\right) &= \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right] + \left(\nabla_ {w} f \left(w _ {k}, x _ {k}\right) - \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right]\right) \\ &\doteq \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right] + \eta_ {k}\\ &=g(w_k)+\eta_k\\ &\doteq \tilde{g}(w_k,\eta_k) \end{align}

其中 ηk\eta_k 是第 kk 个时间步观测带来的噪声。由于 {xk}\{x_k\} 是 i.i.d. 的,因此 Exk[∇wf(wk,xk)]=EX[∇wf(wk,X)]\mathbb{E}_{x_k}\left[\nabla_w f(w_k,x_k)\right]=\mathbb{E}_{X}\left[\nabla_w f(w_k,X)\right],从而

E[ηk]=E[∇wf(wk,xk)−E[∇wf(wk,X)]]=Exk[∇wf(wk,xk)]−EX[∇wf(wk,X)]=0\mathbb {E} \left[ \eta_ {k} \right] = \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, x _ {k}\right) - \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right] \right] = \mathbb {E} _ {x _ {k}} \left[ \nabla_ {w} f \left(w _ {k}, x _ {k}\right) \right] - \mathbb {E} _ {X} \left[ \nabla_ {w} f \left(w _ {k}, X\right) \right] = 0

当 αk\alpha_k 选取合适的值,wkw_k 最终能够收敛到 J(w)J(w) 的极值点 w∗w^*。

事实上,SGD 要解决的优化问题,即求 J(w)=E[f(w,X)]J(w)=\mathbb{E}\left[f(w,X)\right] 的最值,可以转化为求 J(w)J(w) 的梯度 ∇wJ(w)=0\nabla_w J(w)=0 的根,也就是 g(w)=0g(w)=0 的根,这显然可以用 RM 算法去解决,这就从另一个角度得到了 SGD 算法。

应用:均值估计

可以精心设计一个关于随机变量 XX 的待优化目标函数 J(w)J(w),通过应用 SGD 算法间接得到 XX 的均值估计 E[X]\mathbb{E}\left[X\right]。

考虑下面的优化问题

min⁡wJ(w)=E[12∥w−X∥2]≐E[f(w,X)]\min_{w}J(w)=\mathbb{E}\left[\frac{1}{2}\left\|w-X\right\|^2\right]\doteq\mathbb{E}\left[f(w,X)\right]

其中 f(w,X)=12∥w−X∥2f(w,X)=\frac{1}{2}\|w-X\|^2 且梯度为 ∇wf(w,X)=w−X\nabla_wf(w,X)=w-X,显然最优解为 ∇wJ(w)=0\nabla_wJ(w)=0 的根,为 w∗=E[X]w^*=\mathbb{E}\left[X\right]。因此该优化问题等价于均值估计问题。

J(w)J(w) 的 GD 公式为

wk+1=wk−αk∇wJ(wk)=wk−αk∇wE[f(wk,X)]=wk−αkE[∇wf(wk,X)]=wk−αkE[wk−X]\begin{align} w_{k+1}&=w_k-\alpha_k\nabla_wJ(w_k)\\ &=w_k-\alpha_k\nabla_w\mathbb{E}\left[f(w_k,X)\right]\\ &=w_k-\alpha_k\mathbb{E}\left[\nabla_wf(w_k,X)\right]\\ &=w_k-\alpha_k\mathbb{E}\left[w_k-X\right] \end{align}

由于 E[wk−X]\mathbb{E}\left[w_k-X\right] 未知(model-free),因此考虑使用 SGD:

wk+1=wk−αk∇wf(wk,xk)=wk−αk(wk−xk).w_{k+1}=w_{k}-\alpha_{k} \nabla_{w} f ( w_{k} , x_{k} )=w_{k}-\alpha_{k} ( w_{k}-x_{k} ) .

其中 xkx_k 为第 kk 个时间步对随机变量 XX 的采样。

可以发现上述 SGD 的迭代公式与第一部分“均值估计:从 non-incremental 到 incremental”中推广的均值估计公式一样。后者其实就是 SGD 的应用。

收敛性质

既然 SGD 的梯度更新中,梯度的估计是随机的,那么 SGD 迭代的收敛过程是否也是随机的、不稳定的呢?

事实上,SGD 通常拥有很高的收敛效率,并且它拥有一个很有趣的收敛性质:当 wkw_k 离最优点 w∗w^* 非常远时,SGD 的收敛效果和 GD 很类似;只有当 wkw_k 离最优点 w∗w^* 非常近时,SGD 的收敛才会表现出更多的随机性。

对比 GD 中的真实梯度与 SGD 中的估计梯度,它们的相对误差为

δk≐∣∇wf(wk,xk)−E[∇wf(wk,X)]∣∣E[∇wf(wk,X)]∣\delta_ {k} \doteq \frac {\left| \nabla_ {w} f \left(w _ {k} , x _ {k}\right) - \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right] \right|}{\left| \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right] \right|}

设 w∗w^* 为最优点,则 E[∇wf(w∗,X)]=0\mathbb{E}\left[\nabla_wf(w^*,X)\right]=0。因此相对误差可以写为

δk=∣∇wf(wk,xk)−E[∇wf(wk,X)]∣∣E[∇wf(wk,X)]−E[∇wf(w∗,X)]∣=∣∇wf(wk,xk)−E[∇wf(wk,X)]∣∣E[∇w2f(w~k,X)(wk−w∗)]∣\delta_ {k} = \frac {\left| \nabla_ {w} f \left(w _ {k} , x _ {k}\right) - \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right] \right|}{\left| \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right] - \mathbb {E} \left[ \nabla_ {w} f \left(w ^ {*} , X\right) \right] \right|} = \frac {\left| \nabla_ {w} f \left(w _ {k} , x _ {k}\right) - \mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right] \right|}{\left| \mathbb {E} \left[ \nabla_ {w} ^ {2} f \left(\tilde {w} _ {k} , X\right) \left(w _ {k} - w ^ {*}\right) \right] \right|}

其中第二个等式是根据拉格朗日中值定理,w~k\tilde{w}_k 介于 wkw_k 与 w∗w^* 之间。

假设 ff 是严格凸函数,且对于任意的 ww 和 XX 都有 ∇w2f≥c>0\nabla_w^2f\ge c>0(这实际上遵循了 RM 收敛条件)。因此 δk\delta_k 的分母可以写为

∣E[∇w2f(w~k,X)(wk−w∗)]∣=∣E[∇w2f(w~k,X)]∣∣wk−w∗∣≥c∣wk−w∗∣\begin{align} \left| \mathbb{E}[\nabla_{w}^{2} f(\tilde{w}_{k}, X)(w_{k}-w^{*})]\right|&=\left| \mathbb{E}[\nabla_{w}^{2} f(\tilde{w}_{k}, X)]\right| \left| w_{k}-w^{*}\right|\\ &\geq c|w_{k}-w^{*}| \end{align}

由此可得

δk≤∣∇wf(wk,xk)⏞stochastic gradient−E[∇wf(wk,X)]⏞true gradient∣c∣wk−w∗∣⏟distance to the optimal solution\delta_ {k} \leq \frac {| \overbrace {\nabla_ {w} f \left(w _ {k} , x _ {k}\right)} ^ {\text{stochastic gradient}} - \overbrace {\mathbb {E} \left[ \nabla_ {w} f \left(w _ {k} , X\right) \right]} ^ {\text{true gradient}} |}{\underbrace {c \left| w _ {k} - w ^ {*} \right|} _ {\text{distance to the optimal solution}}}

从上式可以直观地看到,相对误差 δk\delta_k 与 wkw_k 和 w∗w^* 之间的距离 ∣wk−w∗∣|w_k-w^*| 成反比:与当 wkw_k 与 w∗w^* 距离很远时,相对误差 δk\delta_k 会很小,导致 SGD 与 GD 的收敛效果很类似;而当 wkw_k 与 w∗w^* 距离很近时,δk\delta_k 上界很大,其取值可能很大,也可能很小,导致 SGD 的收敛会展现出更大的随机性。

假设随机变量 X∈R2X\in\mathbb{R}^2 是二维平面中的点,限制在以原点 (0,0)(0,0) 为中心、边长为 2020 的正方形中,且期望 E[X]=0\mathbb{E}\left[X\right]=\mathbf{0}。下图直观地展示了分别使用 SGD、mini-batch GD(batch=5)和 mini-batch(batch=50)方法,对随机变量 XX 采样 100100 个 i.i.d. 的样本,对 XX 均值估计的效果。可以看到即使初始值离真实值非常远,SGD 也能够很快地收敛到真实值的附近,但在真实值附近表现出了较大的随机性。
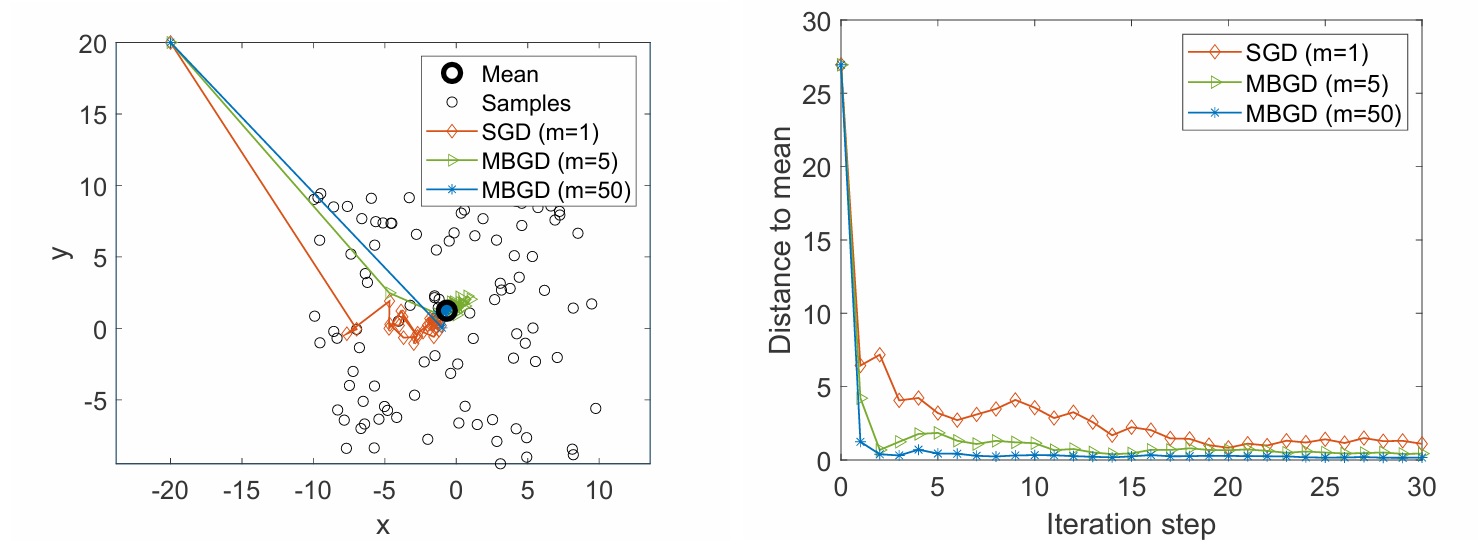
image-20260428142316655

BGD 和 mini-batch GD

在 GD 的梯度更新中,SGD 每次迭代使用一个样本估计梯度。如果每次迭代利用所有的样本估计梯度,就是 batch gradient descent(BGD,批量梯度下降);如果每次迭代利用一部分样本估计梯度,就是 mini-batch gradient descent(MBGD,小批量梯度下降)。

具体而言,对于 J(w)=E[f(w,X)]J(w)=\mathbb{E}\left[f(w,X)\right] 的优化问题,在给予随机变量 XX 的采样 {xi}i=1n\{x_i\}_{i=1}^n 下,它们的梯度更新公式分别为

wk+1=wk−αk1n∑i=1n∇wf(wk,xi),(BGD)wk+1=wk−αk1m∑j∈Ik∇wf(wk,xj),(MBGD)wk+1=wk−αk∇wf(wk,xk)(SGD)\begin{aligned} w _ {k + 1} &= w _ {k} - \alpha_ {k} \frac {1}{n} \sum_ {i = 1} ^ {n} \nabla_ {w} f \left(w _ {k}, x _ {i}\right), &\text{(BGD)}\\ w _ {k + 1} &= w _ {k} - \alpha_ {k} \frac {1}{m} \sum_ {j \in \mathcal {I} _ {k}} \nabla_ {w} f \left(w _ {k}, x _ {j}\right), &\text{(MBGD)}\\ w _ {k + 1} &= w _ {k} - \alpha_ {k} \nabla_ {w} f \left(w _ {k}, x _ {k}\right)&\text{(SGD)} \end{aligned}

其中 Ik\mathcal{I}_k 是第 kk 个时间步获得的所有样本索引 {1,…,n}\{1,\dots,n\} 的一个采样的子集(也要求 i.i.d.),其大小 ∣Ik∣=m|\mathcal{I}_k|=m。

当 MBGD 中 Ik\mathcal{I}_k 大小 m=nm=n 时,MBGD 并不等同于 BGD,因为 MBGD 是从所有样本中随机采集 nn 次获得的样本子集,这些样本间可能存在重复;而 BGD 是直接使用所有样本。这也是为什么这里强调 Ik\mathcal{I}_k 是**“采样的”**子集。

从上一部分“收敛性质”的例子中也可以看到,相比于 SGD,mini-batch 由于每次估计梯度使用了更多的样本,会获得更加精确的梯度估计,导致收敛更快、更稳。